La prioridad central de nutri. es la exactitud de los datos nutricionales almacenados, una condición que hereda cada función de IA. Estas dos se entregaron juntas: una capa semántica para buscar en el catálogo y «Pregunta a tu registro», un flujo de preguntas en lenguaje natural sobre el diario de alimentos. Ambas siguen la misma regla: el LLM decide qué consultar y cómo explicarlo, pero nunca es la fuente de una cifra.
Búsqueda semántica: palabras clave primero, vectores cuando aportan
La búsqueda usaba solo ilike: «fruta cítrica» no devolvía nada aunque el catálogo tuviera naranja, toronja y limón. Con 634 alimentos —490 creados por el usuario y una base compartida de 144 elementos de USDA—, el vocabulario de la persona dejó de coincidir con los nombres de las filas.
El diseño es deliberadamente conservador:
- Una columna anulable
embedding vector(768)y una RPCmatch_foodsconsecurity invoker, de modo que la seguridad por filas siga decidiendo qué puede encontrar cada usuario. Distancia coseno, un límitemax_distcontra ruido y ningún índice HNSW a propósito: con unas 600 filas conviene una búsqueda secuencial; el umbral para añadir el índice —unas 10 mil— quedó documentado en lugar de implementarse antes de necesitarlo. - Híbrida, no basada primero en vectores. Las coincidencias por palabra clave mantienen prioridad. Solo si hay menos de ocho resultados, se genera el embedding de la consulta y se agregan resultados semánticos sin duplicados, después de los de palabras clave. Si falla la llamada de embedding —sin clave, red o cuota—, la función devuelve
nully la búsqueda funciona como antes: degradada, nunca rota. - Un detalle importante:
gemini-embedding-001normaliza L2 únicamente su salida completa de 3072 dimensiones. Al usar 768 dimensiones hay que normalizar de nuevo o la distancia «coseno» será incorrecta sin avisar. - La fórmula del texto a convertir en vector (
name + ' ' + brand) queda fija: se usó para cargar todo el catálogo y cambiarla degradaría silenciosamente los vectores existentes.
La carga inicial también es parte del caso: unos 4 MB de vectores nunca pasaron por el contexto del agente de IA. Dos RPC temporales con security definer —listar pendientes y aplicar un lote, con protección para no sobrescribir valores existentes— y un script local reanudable enviaron los 634 registros por HTTP, en lotes de 20 y con pausas de 65 segundos porque el nivel gratuito del servicio limita llamadas por minuto. El proceso tardó unos diez minutos y ambas RPC se eliminaron después.
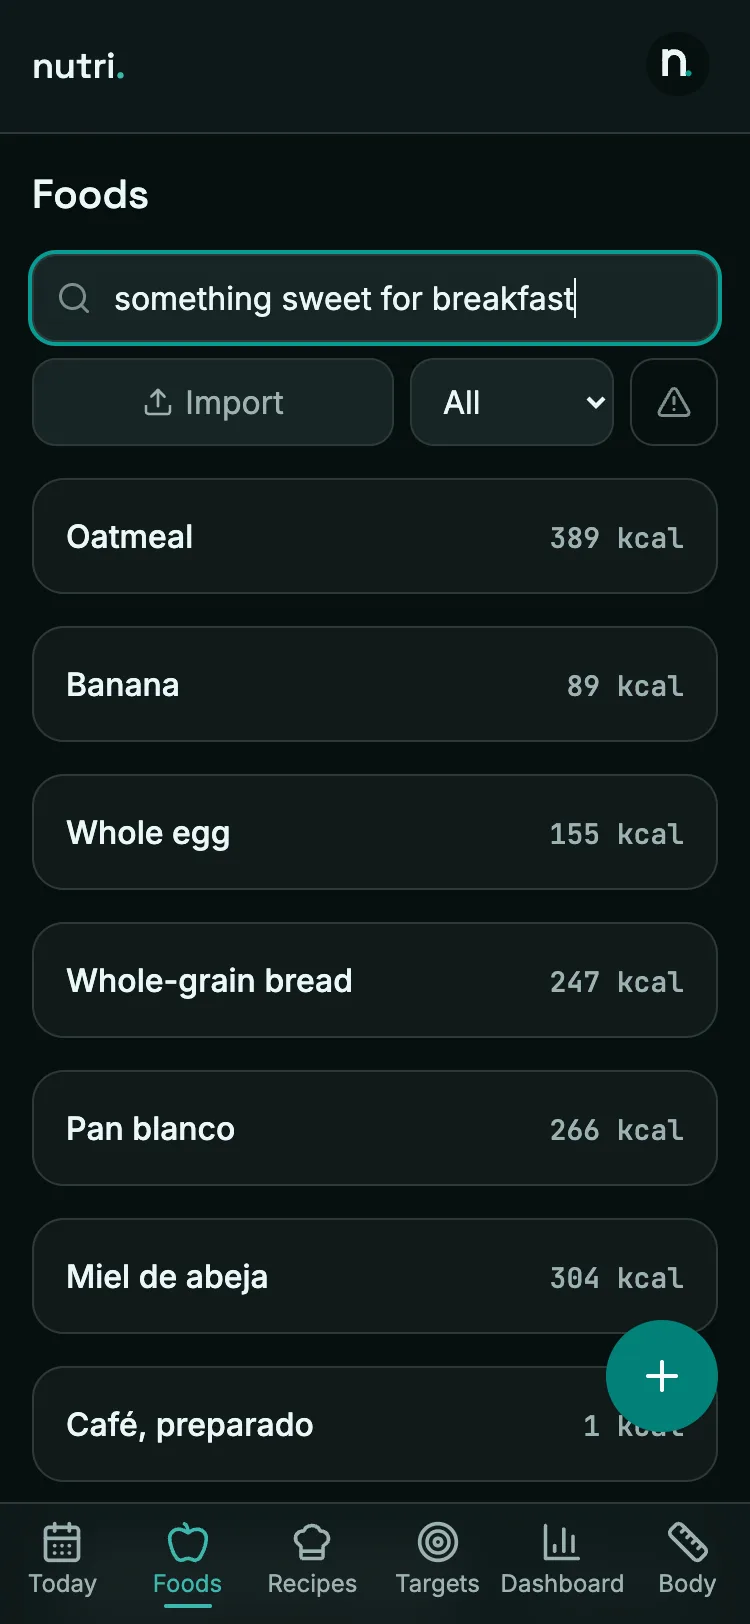
Pruebas en vivo registradas: «fruta cítrica» → naranja, toronja y limón, sin coincidencias literales; «pescado azul» → atún, huachinango y salmón, incluido un resultado entre idiomas para «Canned tuna in water».
Pregunta a tu registro: RAG cuya recuperación es SQL
La solución obvia —convertir el diario en vectores y recuperar por similitud— habría sido peor en precisión y costo. Los datos del diario son tabulares y ya son exactos en las vistas SQL. Por eso el flujo usa RAG estructurado en tres pasos:
- Planificar. Un modelo convierte la pregunta en
{date_from, date_to, nutrients[], need_detail}como salida estructurada. Las claves válidas de nutrientes se incorporan al prompt desde la única fuente de verdad de la app. Un saneador puro y probado corrige las posibles fallas del modelo: fechas faltantes → últimos 30 días, fechas futuras → hoy, rangos → máximo 92 días —se informa en la interfaz— y nutrientes desconocidos → se eliminan. - Recuperar. Los totales diarios del rango vienen de las mismas vistas SQL que lee el panel; el detalle por entrada solo se consulta si el plan lo solicita; los objetivos se resuelven por día con la lógica existente. No se recalcula ni se estima nada.
- Responder. Las filas recuperadas se entregan como contexto compacto tipo CSV —hasta 400 entradas de mayor aporte calórico, con aviso si se alcanza el límite— y el modelo recibe la instrucción de usar exclusivamente cifras presentes en ese contexto, citar días y alimentos concretos, y describir sin prescribir.
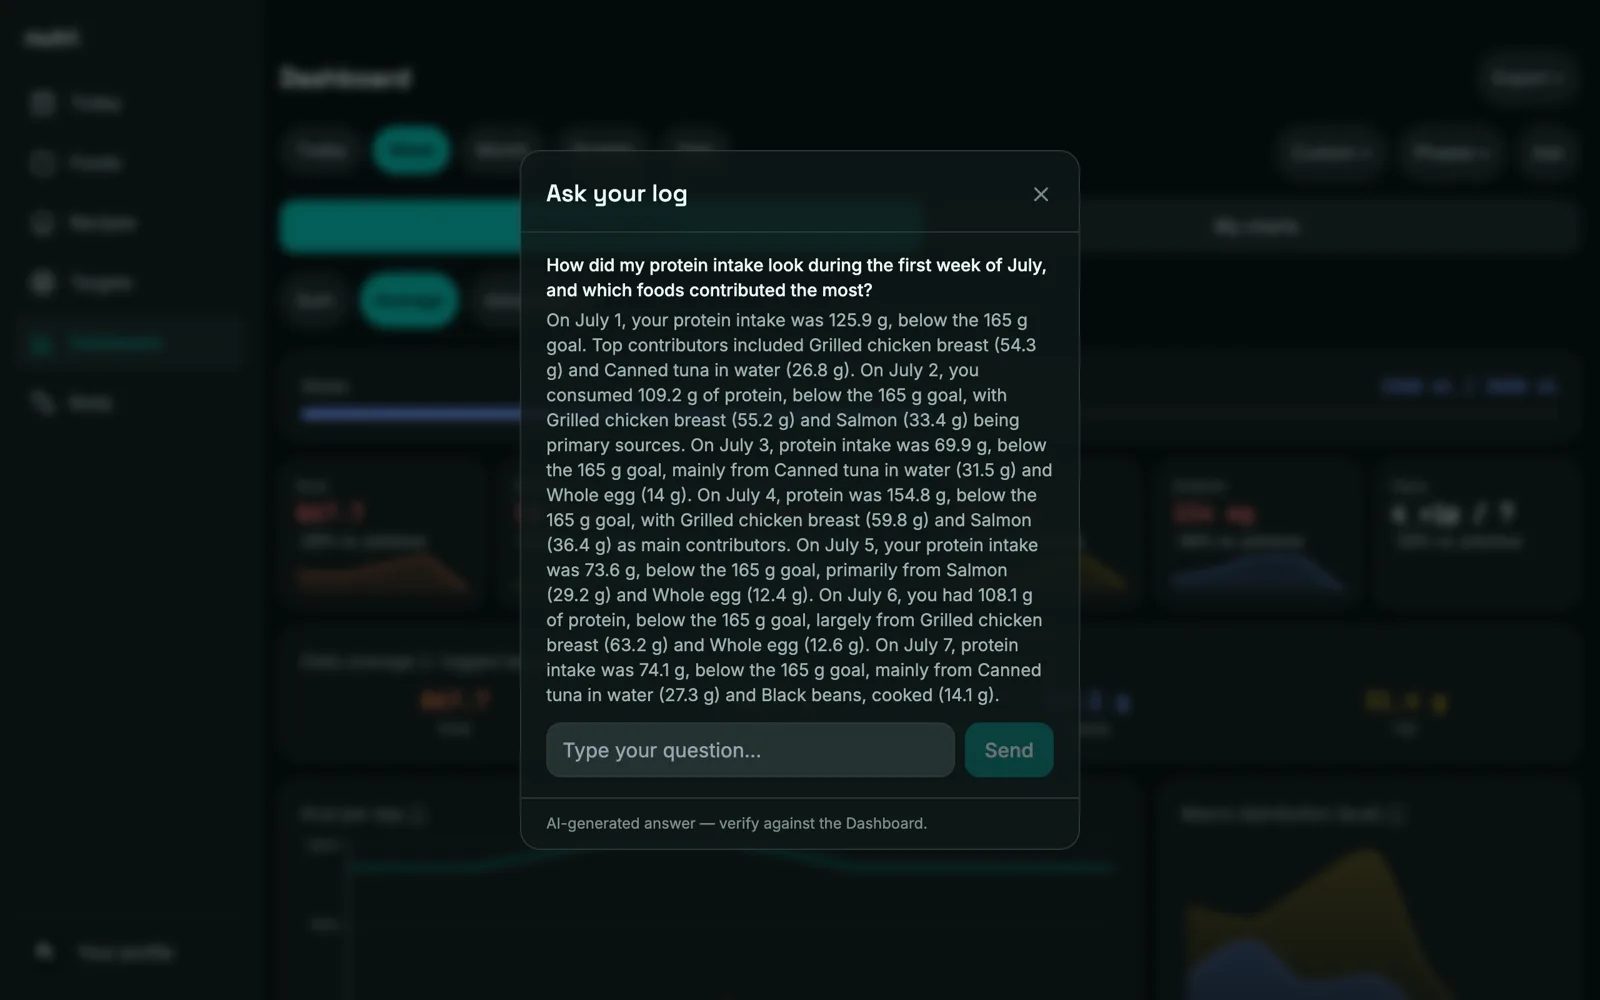
Verificación hasta el tercer decimal
La afirmación «solo cita cifras recuperadas» se probó de punta a punta. Ante «¿qué alimentos me aportaron más sodio en las últimas dos semanas?», la respuesta citó «pan integral, 91 g → 409.5 mg» el 2 de julio. La vista de la base de datos indica 409.500. Las piezas puras del flujo —normalización de vectores, unión de resultados, saneamiento del plan y formato del contexto— tienen pruebas unitarias, 17 de las 186 de la suite. La hoja muestra un aviso fijo: Respuesta generada por IA; verifique en el panel. Las cifras reales están en el contexto, pero la prosa sigue viniendo de un modelo; la mitigación consiste en reconocerlo, no en fingir que el riesgo es cero.
Límites documentados
Los alimentos creados fuera de la app —por MCP o REST— no tienen embedding hasta que alguien los edita y guarda; mientras tanto, la búsqueda híbrida los encuentra por palabra clave. El límite de distancia acepta algo de ruido a cambio de coincidencias entre idiomas y es un parámetro de ejecución, no una migración. La hoja de preguntas no conserva una conversación: cada pregunta es independiente. Las tres son decisiones documentadas con posibles rutas de mejora.
El código está en el repositorio público github.com/vryahn/nutri: src/lib/ai.js y supabase/migrations/017_foods_embedding.sql. Contexto del sistema completo: nutri. — aplicación en producción con un entorno agéntico.